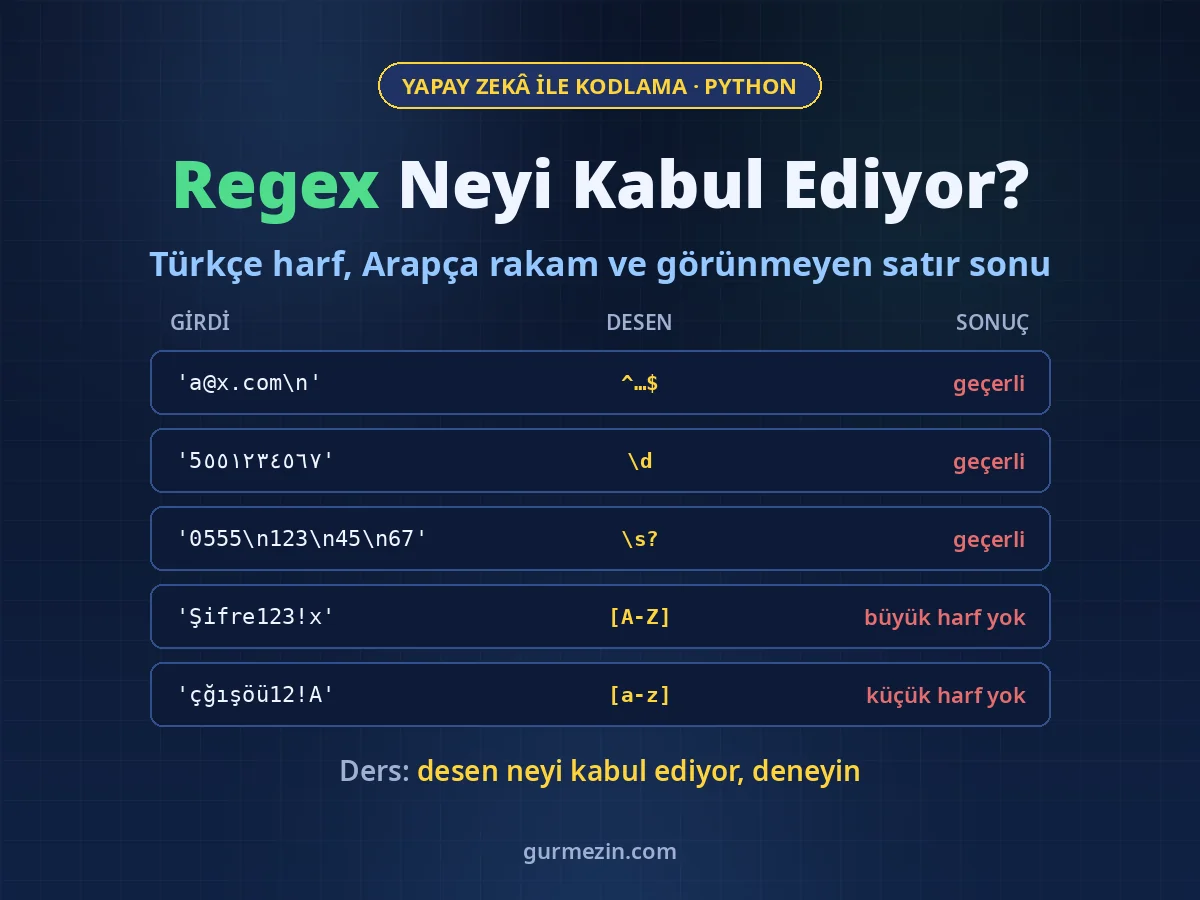

21 Eylül’de yayımladığımız regex doğrulama yazısında e-posta, telefon ve şifre için üç kontrol göstermiştik. Yazı bu kontrollerin “kirli veriyi kapıda durdurduğunu” söylüyordu. Kodu bir yapay zekâ yazmıştı. Kodu bu kez kenar durumlarla çalıştırdık: sonunda satır sonu olan bir e-posta, Arapça rakamlarla yazılmış bir telefon numarası, Türkçe harfli bir şifre. Desenlerin bir kısmı reddetmesi gerekeni kabul etti, bir kısmı da kabul etmesi gerekeni reddetti. Bu yazıda dört örneği gerçek çıktılarıyla ve düzeltmeleriyle anlatıyoruz. Bu arada özgün yazımızdaki yanlış bir örneği de düzeltiyoruz.
Neden Bu Konu?
Regex desenleri kısa ve kendinden emin görünür. ^...$ ile sarılmış bir desen “baştan sona kontrol ediyorum” der, \d “rakam”, \s “boşluk” der. Yapay zekâ bu desenleri saniyeler içinde, açıklayıcı yorumlarla birlikte yazıyor. Yorumlar da desen kadar ikna edici: özgün kodda $ için “Concludes with a period and at least a 2-character Top-Level Domain” yazıyor.
Bu yazıdaki dört sorunun ortak noktası şu: Python’ın re modülü, metin (str) desenlerinde varsayılan olarak Unicode kurallarıyla çalışıyor. \d yalnızca 0–9 değil, dünyadaki bütün rakam sistemlerini kapsıyor. \s satır sonunu ve bölünemez boşluğu da kapsıyor. [A-Z] ise tam tersine yalnızca İngiliz alfabesini kapsıyor. Hiçbiri Python’da hata değil, hepsi belgelerde yazıyor. Sorun, desenin yazıldığı niyetle yaptığı işin farklı olması.
26 Ekim yazımızda kontrol etmeden “tamamlandı” diyen kodu anlatmıştık. Buradaki kod kontrol ediyor, ama kontrol ettiğini sandığı şeyi değil.
Proje bilgisi Yazarlar: Ahmet Aksoy & Claude · Tarih: 26.10.2026 Ortamlar: Python 3.12.3 (Ubuntu 24.04, yerel ayar
tr_TR.UTF-8) ve Docker’dapython:3.9-slim,3.13-slim,3.15-rc-slim(LC_ALL=C.UTF-8). Dört ortamda çıktılar birebir aynı. İncelenen proje: 38 · Örnek kod: proje 47
1. $ Bir Satır Sonuna İzin Veriyor
Özgün e-posta deseni şöyle:
email_pattern = r"^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$"
return bool(re.match(email_pattern, email))
$ “metnin sonu” diye öğretilir. Python belgeleri ise biraz daha fazlasını söylüyor: $ metnin sonunda ya da metnin sonundaki satır sonu karakterinin hemen önünde eşleşir. Denedik:
'a@x.com'            says True   checks True
'a@x.com\n'          says True   checks False
'a@x.com\n\n'        says False  checks False
Sonunda bir satır sonu (\n) olan adres geçerli sayılıyor, iki satır sonu olan reddediliyor. Bu karakter ekranda görünmüyor. Bir formdan, bir dosyadan ya da input() dışında okunan bir satırdan rahatlıkla gelebilir.
Bunun bir önemi var mı? Kontrolden geçen adresi UNIQUE (benzersiz) kuralı olan bir veritabanı sütununa yazdık. Aynı adresi bir kez düz, bir kez sonunda satır sonuyla kaydettik:
says                 2 accounts for one address (UNIQUE did not help)
checks               1 account
Veritabanı için "ahmet@gurmezin.com" ile "ahmet@gurmezin.com\n" iki ayrı metin. Aynı kişi iki hesap açabiliyor ve “bu adres zaten kayıtlı” kontrolü işe yaramıyor. Özgün yazımız bu kontrollerin “enjeksiyon saldırılarının önüne geçtiğini” de söylüyordu. Satır sonu, tam da e-posta başlıklarına sızdırılmaya çalışılan karakter.
Düzeltme tek kelime: re.match yerine re.fullmatch. Bu fonksiyon desenin metnin tamamını kapsamasını ister, ^ ve $‘a da gerek kalmaz:
EMAIL_CHECKS = re.compile(r"[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}")

def email_checks(email: str) -> bool:
    return EMAIL_CHECKS.fullmatch(email) is not None
^...$ alışkanlığını bırakmak istemezseniz $ yerine \Z yazın. \Z gerçekten yalnızca metnin sonunda eşleşir.
Kendi yazımızdaki hata: Özgün yazının “Ne Öğrendik?” bölümünde “^ ve $ işaretlerini unutursanız user@com123 gibi hatalı bir e-posta bile geçerli sayılabilir” demiştik. Bunu da denedik: user@com123 adresinde nokta olmadığı için desen onu çapalı da çapasız da reddediyor. Çapanın gerçekten fark yarattığı örnek a@x.com123: çapasız re.match bu adresi kabul ediyor, çapalı desen reddediyor. Yani yazı doğru bir kuralı yanlış bir örnekle anlatıyordu. $‘ın kendi açığını ise hiç anmıyordu.
E-posta deseninin başka gevşeklikleri de var: a..b@x.com, .a@x.com ve a@-x.com geçerli sayılıyor, user@örnek.com reddediliyor. Bunları 38 numaralı projenin README dosyasına not olarak ekledik. Özgün yazının da dediği gibi, bir adresin gerçekten var olup olmadığını regex değil, adrese gönderilen doğrulama e-postası söyler.
2. \d Her Rakamı Kabul Ediyor
Telefon deseni şöyle:
phone_pattern = r"^(?:\+90|0)?\s?([5]\d{2})\s?(\d{3})\s?(\d{2})\s?(\d{2})$"\d “rakam” demek, ama hangi rakam? Python’da metin desenlerinde \d, Unicode’un “ondalık rakam” sınıfındaki her karakterle eşleşir: Arapça (٥), Farsça (۵), Devanagari (५) ve onlarca başka sistem. Telefon numarasını Arapça rakamlarla yazdık:
input                '5٥٥١٢٣٤٥٦٧'  (Arabic-Indic digits)
says                 ('5٥٥', '١٢٣', '٤٥', '٦٧')
checks               None
int()                5551234567  -> looks the same after conversion
==                   False  -> but not as text
ascii                UnicodeEncodeError at position 1
Özgün kod bu numarayı kabul ediyor ve “temizlenmiş çıktı” olarak ekrana Area: (5٥٥) Number: ١٢٣-٤٥-٦٧ yazıyor. İşin ilginç yanı, int() bu metni sorunsuzca 5551234567 sayısına çeviriyor. Yani numarayı sayıya çeviren bir kontrol “her şey yolunda” der. Ama metin olarak saklandığında "5551234567" ile eşit değil, aynı numaranın iki kaydı oluşabilir. Numarayı yalnızca ASCII kabul eden bir SMS servisine göndermek istediğinizde de UnicodeEncodeError alırsınız.
Neden yalnızca bir 5 ASCII? Çünkü desen ilk rakamı [5] olarak yazmış, bu da yalnızca ASCII 5 ile eşleşiyor. Gerisi \d.
Düzeltme: 0–9’u kastediyorsanız bunu açıkça yazın: [0-9]. Ya da desenin tamamına re.ASCII bayrağını verin. Bu bayrak \d, \w ve \s‘yi ASCII ile sınırlar.
3. \s Yalnızca Boşluk Değil
Aynı telefon deseninde numaranın parçaları arasında \s?, yani “isteğe bağlı bir boşluk” var. \s ise boşluktan fazlası: satır sonu, sekme, bölünemez boşluk (NBSP, \xa0) ve Unicode’un başka boşluk karakterleri. Dört girdiyle denedik:
'0555 123 45 67'     says ('555', '123', '45', '67') checks ('555', '123', '45', '67')
'0555\n123\n45\n67'  says ('555', '123', '45', '67') checks None
'0555\xa0123\xa045\xa067' says ('555', '123', '45', '67') checks None
'5551234567\n'       says ('555', '123', '45', '67') checks None
Dört satıra bölünmüş bir numara geçerli. Sonunda satır sonu olan numara da 1. bölümdeki $ yüzünden geçerli. Bölünemez boşluk, web sayfalarından ve kelime işlemcilerden kopyalanan metinlerde sık görülür. Bu karakteri kabul etmek isteyebilirsiniz, ama o zaman bilerek kabul etmeniz ve saklamadan önce normal boşluğa çevirmeniz gerekir. Özgün kod, kabul ettiği numarayı olduğu gibi bırakıyor.
Düzeltme: Önce neyi kabul edeceğinize karar verin, sonra girdiyi kendiniz sadeleştirin, en son sade bir desenle kontrol edin:
PHONE_CHECKS = re.compile(r"(?:\+90|0)?(5[0-9]{2})([0-9]{3})([0-9]{2})([0-9]{2})")

def phone_checks(phone: str):
    # Yalnızca normal boşluklar siliniyor; satır sonu ve NBSP bilerek reddediliyor.
    match = PHONE_CHECKS.fullmatch(phone.replace(" ", ""))
    return match.groups() if match else None
Bu sürümde desenin içinde hiç \s ya da \d yok. Her karakterin ne olabileceği açıkça yazılı.
4. [A-Z] Türkçe Harfleri Tanımıyor
Şifre kontrolü, her kural için ayrı bir re.search kullanıyor: [A-Z] büyük harf, [a-z] küçük harf, \d rakam, [@$!%*?&] özel karakter. Üç Türkçe ve bir İngilizce şifreyle denedik:
Şifre123!x           says ['uppercase']              checks STRONG
çğışöü12!A           says ['lowercase']              checks STRONG
Passw0rd#            says ['special']                checks STRONG
Şifre123!x için kod “büyük harf yok” diyor, çünkü Ş İngiliz alfabesinde yok. çğışöü12!A için “küçük harf yok” diyor, oysa şifrenin yarısı küçük harf. Passw0rd# reddediliyor, çünkü # beş karakterlik özel karakter listesinde değil. Kullanıcı açısından bu üç mesaj da yanlış ve kafa karıştırıcı.
İlk akla gelen yama re.IGNORECASE (re.I) bayrağını eklemek olabilir. Bunu da denedik ve Türkçe harflerin hangilerinin [a-z] ile eşleştiğine baktık:
re.I [a-z] matches 'ıİſK' of 'ıİşŞğĞçÇöÖüÜſK'Sonuç ilk bakışta tuhaf. ı ve İ eşleşiyor, çünkü Unicode’da ı‘nın büyük hali I, İ‘nin küçük hali i. ş, ğ, ç, ö, ü ise eşleşmiyor. Bunlara iki yabancı da katılıyor: ſ (eski Latin yazısındaki “uzun s”) ve K (Kelvin işareti). Yani re.I Türkçe sorununu çözmüyor, yalnızca kuralı daha az öngörülebilir yapıyor.
Düzeltme: Harf sınıfını regex’e değil, Python’ın kendi karakter yöntemlerine sormak. str.isupper() ve str.islower() Unicode harf bilgisini kullanır, Türkçe harfleri doğru tanır:
def password_checks(password: str) -> list:
    missing = []
    if len(password) < 8:
        missing.append("length")
    if not any(c.isupper() for c in password):
        missing.append("uppercase")
    if not any(c.islower() for c in password):
        missing.append("lowercase")
    if not any(c.isdecimal() for c in password):
        missing.append("digit")
    if all(c.isalnum() or c.isspace() for c in password):
        missing.append("special")
    return missing
Özel karakter için de bir liste tutmak yerine “harf, rakam ya da boşluk olmayan herhangi bir karakter” kuralını kullandık.
Rakam kuralında bilerek Unicode’a izin verdik (isdecimal()), çünkü telefondan farklı olarak şifre başka bir sisteme gönderilmiyor. Özgün kod da \d kullandığı için Parola١٢٣!x şifresini zaten “güçlü” sayıyordu, ama hata mesajı kullanıcıya “[0-9] rakamı girin” diyordu. Hangisini seçerseniz seçin, kural ile mesajın aynı şeyi söylemesi gerekir.
Bir not daha: ABD’nin standartlar kurumu NIST’in güncel kimlik doğrulama rehberi (SP 800-63B-4), “büyük harf, rakam, özel karakter karışımı” gibi bileşim kurallarını açıkça yasaklıyor (“SHALL NOT impose other composition rules”). Rehber bunun yerine uzunluğa ve sızdırılmış şifre listelerine bakılmasını istiyor, şifrelerde Unicode karakterlerin de kabul edilmesini öneriyor. Yani Şifre123!x gibi bir şifreyi Türkçe harfi yüzünden reddeden kod, bu rehbere göre iki kez yanlış. Kendi sisteminiz için şifre kuralı yazıyorsanız önce bu rehbere bakmanızı öneririz.
Dördü Bir Arada
Dört örneği tek bir betikte topladık (proje 47). Her bölüm aynı girdileri önce özgün desenle (“says”), sonra düzeltilmiş sürümle (“checks”) çalıştırıyor. Betik yalnızca standart kütüphaneyi kullanıyor, ağ ya da dosya gerektirmiyor. Kendi bilgisayarımızdaki çıktısı:
Python 3.12.3

== 1. '$' and a trailing newline ==
  'a@x.com'            says True   checks True
  'a@x.com\n'          says True   checks False
  'a@x.com\n\n'        says False  checks False
  says                 2 accounts for one address (UNIQUE did not help)
  checks               1 account

== 2. '\d' and Unicode digits ==
  input                '5٥٥١٢٣٤٥٦٧'  (Arabic-Indic digits)
  says                 ('5٥٥', '١٢٣', '٤٥', '٦٧')
  checks               None
  int()                5551234567  -> looks the same after conversion
  ==                   False  -> but not as text
  ascii                UnicodeEncodeError at position 1

== 3. '\s' is more than a space ==
  '0555 123 45 67'     says ('555', '123', '45', '67') checks ('555', '123', '45', '67')
  '0555\n123\n45\n67'  says ('555', '123', '45', '67') checks None
  '0555\xa0123\xa045\xa067' says ('555', '123', '45', '67') checks None
  '5551234567\n'       says ('555', '123', '45', '67') checks None

== 4. '[A-Z]' and Turkish letters ==
  Şifre123!x           says ['uppercase']              checks STRONG
  çğışöü12!A           says ['lowercase']              checks STRONG
  Passw0rd#            says ['special']                checks STRONG
  re.I                 [a-z] matches 'ıİſK' of 'ıİşŞğĞçÇöÖüÜſK'
Betiği Python 3.9, 3.13 ve 3.15 adaylarında Docker’da, C.UTF-8 yerel ayarıyla da çalıştırdık. Çıktılar Python sürüm satırı dışında birebir aynı. 19 Ekim’deki sqlite3 tuzağından farklı olarak burada ne Python sürümü ne de bilgisayarın Türkçe yerel ayarı fark yaratıyor. Belirleyici olan Unicode kuralları ve bunlar her yerde aynı.
Yapay Zekânın Yazdığı Regex’i Değerlendirirken Ne Arıyoruz?
re.matchve$yan yana mı? O zaman sonda bir satır sonuna izin veriliyor demektir. Bütün metni kontrol etmek istiyorsanızre.fullmatchkullanın.\d,\w,\sgerçekten istediğiniz şey mi? Bunlar metin desenlerinde Unicode sınıflarıdır. Yalnızca ASCII istiyorsanız[0-9]yazın ya dare.ASCIIbayrağını kullanın.[A-Z]ya da[a-z]kimin alfabesi? Türkçe kullanıcıların yazacağı bir metinsestr.isupper()vestr.islower()daha doğru.re.Ibu sorunu çözmez.- Kabul edilen değer saklanmadan önce sadeleştiriliyor mu? Kontrolden geçen metin, kontrolün izin verdiği her tuhaflığı veritabanına taşır. Önce sadeleştirip sonra kontrol etmek, kontrolden sonra neyle uğraştığınızı bilmenizi sağlar.
- Desen kötü girdiyle denendi mi? Özgün betikteki örnek girdilerin hepsi düz ASCII’ydi. Dört sorunun hiçbiri bu girdilerle görünmüyor. Biz onları bir satır sonu, bir Arapça rakam, bir bölünemez boşluk ve bir Türkçe harfle denediğimizde gördük.
Bu hatalar yapay zekâya özgü değil, yıllardır insanların yazdığı kodda da var. Yapay zekâ onları bu koddan öğrendi. Bu yüzden yapay zekâ size bir doğrulama deseni yazdığında, ondan desenle birlikte “bu desen neleri kabul ediyor?” sorusuna cevap veren birkaç kötü girdi örneği de istemenizi öneririz. Bu yazıdaki girdileri doğrudan kullanabilirsiniz.
Kodu Kendiniz Deneyin
Dört örneğin tamamı proje 47’de tek bir main.py dosyasında. Betik Python 3.9 veya daha yenisinde çalışıyor ve ek paket gerektirmiyor:
python3 main.pyÖzgün kod 38 numaralı projede duruyor. README dosyasına bu sınırlamaları “Limitations” (Sınırlamalar) bölümü olarak ekledik.
Kaynaklar
- re — Python belgeleri:
$,\Z,\d,\svere.ASCIItanımları - re.fullmatch — Python belgeleri
- str.isupper / str.islower — Python belgeleri
- NIST SP 800-63B: Kimlik doğrulama ve yaşam döngüsü yönetimi
- Python’da Regex Sınır Bekçiliği: E-posta, Telefon ve Şifre Doğrulama (özgün yazı)
- “Tamamlandı” Diyen Kod: Kontrol Etmeden Başarı Bildiren Beş Örnek
Ahmet Aksoy & Claude
Not: Bu yazıda incelediğimiz kodu ve benzer projelerin kaynak kodlarını https://github.com/ahmetax/practical-python-examples adresinde bulabilirsiniz.