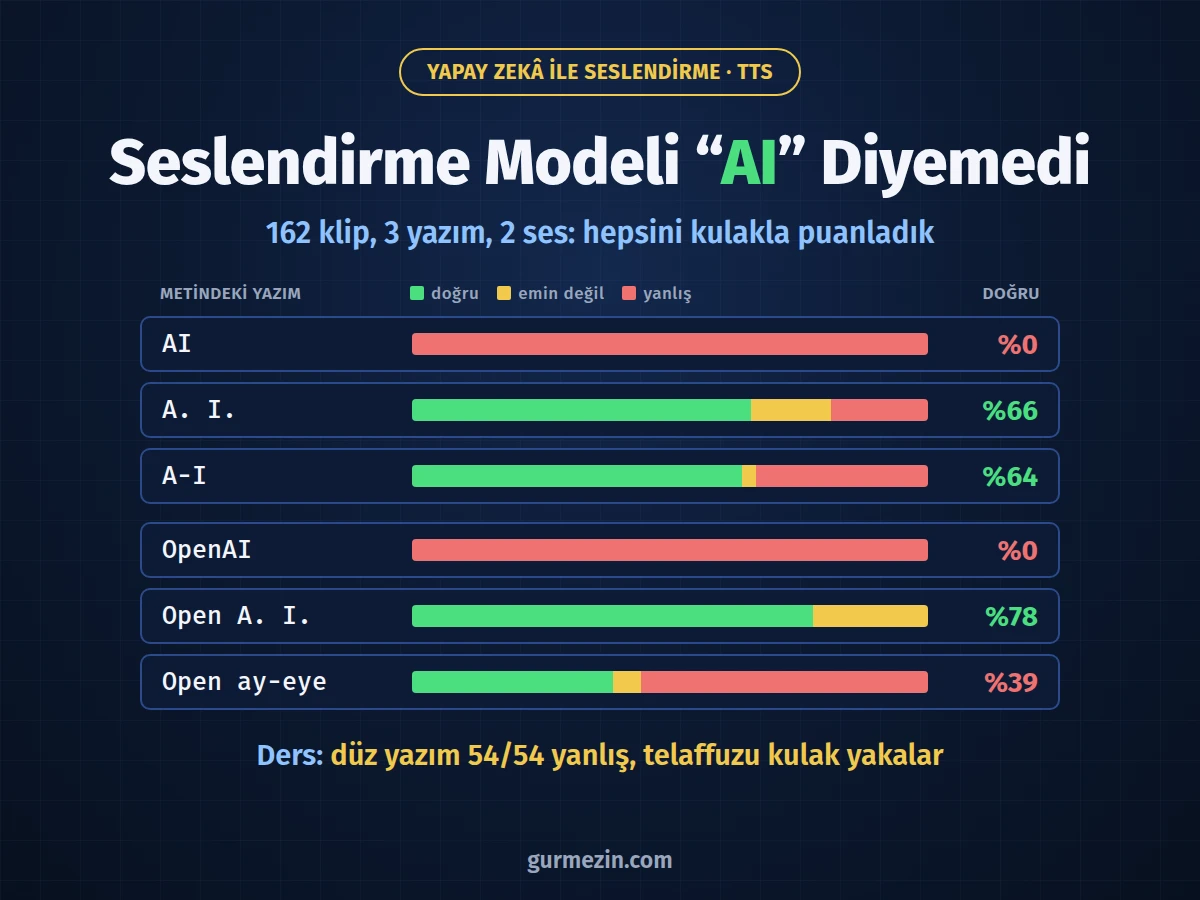

İngilizce YouTube kanalımız Starfield Code’da yapay zekâ konularını anlatıyoruz. Bu yüzden seslendirmede en sık geçen kelime “AI”. Videoları yerelde çalışan, açık kaynaklı bir metinden sese (text-to-speech, TTS) modeliyle seslendiriyoruz. Bu model “AI” kelimesini düzgün okuyamıyordu, daha kötüsü bazen okuyup bazen okuyamıyordu. Sonunda oturup ölçtük: 162 klip ürettik, hepsini kulakla dinleyip puanladık. Bu yazıda neyi nasıl test ettiğimizi ve hangi yazımın işe yaradığını anlatıyoruz.
Sorun: Aynı Kelime, Her Seferinde Başka Ses
Seslendirme için Resemble AI’ın Chatterbox Multilingual modelini kullanıyoruz. MIT lisanslı, internet ya da kredi kartı istemiyor, eski bir GTX 1060 ekran kartında gerçek zamanın 2–3 katı sürede çalışıyor. Kanalın sesi bir ses klonu: modelin kendi yerleşik sesiyle okunmuş bir paragrafı 0,8 kat yavaşlatıp referans olarak verdik. Böylece yabancı izleyicilerin rahat takip edebileceği, dakikada yaklaşık 200 kelimelik bir tempo elde ettik.
“AI” sorunu ilk videodan beri peşimizdeydi:
- İlk videoda “OpenAI” kelimesini “Open A.I.” diye yazdık, model “ey ay ay” diye okudu. “Open ay-eye” yazımı işe yaradı.
- Üçüncü videoda “AI” kelimesini “A-I” olarak yazdık, kulakla dinledik, onayladık.
- Beşinci videoyu hazırlarken aynı “A-I” yazımı dört yerde yanlış çıktı. Yazımı “A. I.” yaptık, düzeldi.
Yani aynı yazım bir videoda çalışıyor, ötekinde çalışmıyordu. Fark, her cümle için kullanılan rastgelelik tohumu (seed) ve cümlenin kendisiydi.
İşin can sıkıcı yanı, otomatik kontrolümüzün bu hataları hiç yakalamamasıydı. Her seslendirmeden sonra sesi Whisper ile yazıya döküp senaryoyla karşılaştırıyoruz. Whisper, “ey ay ay” duyduğunda da bağlamdan tahmin edip “AI” yazıyordu. Kontrol “her şey yolunda” diyor, kulak ise “yanlış” diyordu. Bu, daha önce “Tamamlandı” Diyen Kod yazısında anlattığımız durumun ses tarafındaki karşılığı: kontrol çalışıyor ama asıl soruyu sormuyor.
Testi Nasıl Kurduk?
Sorunun kaynağı için iki tahminimiz vardı:
- Referans ses: Yavaşlatılmış ses klonu modelin telaffuzunu bozuyor olabilirdi.
- Modelin kendisi: Çok dilli model İngilizce kısaltmaları zaten iyi okuyamıyor olabilirdi.
Bu ikisini ayırmak için her cümleyi hem kendi klon sesimizle (kanal_v2) hem de modelin yerleşik sesiyle ürettik. Test düzeni şöyleydi:
| Boyut | Değerler |
|---|---|
| Cümle | 9 (6 tanesi “AI”, 3 tanesi “OpenAI” içeriyor) |
| Yazım | 3 (düz yazım + 2 farklı yeniden yazım) |
| Tohum | 3 (11, 5, 23) |
| Ses | 2 (klon ses, yerleşik ses) |
| Toplam | 162 klip |
Cümleleri, kelimenin farklı konumlarda geçeceği şekilde seçtik: cümle başı (“AI is not magic.”), “why” sonrası (“So why does AI make things up?”), bir isimden önce (“Every AI model…”), iyelik eki (“The AI’s answer…”) ve cümle sonu (“…wrong about AI.”).
Test betiğini, puanlama sayfasını ve sonuçların analizini Claude yazdı; dinleyip puanlamayı biz yaptık. Üretim, klip başına ortalama 11 saniyeyle yarım saat kadar sürdü. Puanlama için küçük bir HTML sayfası hazırladık: her klibin yanında oynat düğmesi ve doğru / emin değilim / yanlış seçenekleri vardı. Klavyeden 1-2-3’e basınca puan kaydediliyor ve sıradaki klip kendiliğinden çalıyordu. 162 klibi bu şekilde kısa sürede dinlemek mümkün oldu. Puanlar tarayıcıda tutuldu, sonunda bir JSON dosyasına aktarıldı.
Dinlerken yalnızca “AI” kelimesinin söylenişine baktık. Bazı kliplerin sonunda modelin eklediği anlamsız mırıltılar vardı, bunları puana katmadık. Dört klip kararsız kaldığı için puansız bırakıldı. 158 klip puanlandı.
Sonuçlar
| Metindeki yazım | Doğru | Emin değil | Yanlış |
|---|---|---|---|
AI |
0 | 0 | 36 |
A. I. |
21 | 5 | 6 |
A-I |
23 | 1 | 12 |
OpenAI |
0 | 0 | 18 |
Open A. I. |
14 | 4 | 0 |
Open ay-eye |
7 | 1 | 10 |
İlk satır tartışmaya yer bırakmıyor: düz yazılmış “AI” ve “OpenAI”, 54 klibin 54’ünde yanlış okundu. Bu sonuç iki seste de, üç tohumda da aynı.
Öteki bulgular:
- Suçlu referans ses değil. Klon ses ile yerleşik ses arasında anlamlı fark çıkmadı (“AI” cümlelerinde doğru oranı %40’a karşı %44). Tohumlar arasında da fark yok (%38–43). Sorun modelin kendisinde.
- OpenAI için kazanan belli: “Open A. I.” yazımı hiç yanlış okunmadı. İlk videodan beri kullandığımız “Open ay-eye” ise yarıdan fazlasında yanlış çıktı.
- AI için “A. I.” öne çıkıyor: Klon sesimizde “A. I.” %75, “A-I” %50 doğru okundu.
- Kelimenin cümledeki yeri belirleyici. Cümle ortasında, bir isimden önce (“AI model”, “Generative AI”) iki yeniden yazım da neredeyse her zaman doğru. “AI” cümlenin ilk ya da son kelimesi olunca doğru oranı %17–50 aralığına düşüyor.
Pratikte Ne Yapıyoruz?
Altyazıda “AI” görünmeye devam ediyor. Değişen tek şey, TTS modeline giden metin. Seslendirme betiğimizde yalnızca konuşmayı etkileyen bir sözlük var:
import re

# Yalnızca seslendirmeye giden metni değiştirir; altyazı orijinal kalır
SAY = {
    "OpenAI": "Open A. I.",
    "AI": "A. I.",
}

def spoken(text: str) -> str:
    # Uzun anahtarlar önce: "OpenAI" kuralı "AI" kuralından önce uygulanmalı
    for key in sorted(SAY, key=len, reverse=True):
        text = re.sub(rf"\b{re.escape(key)}\b", SAY[key], text)
    return text

print(spoken("Why do AI models listen to OpenAI's tokenizer?"))
# Çıktı:
# Why do A. I. models listen to Open A. I.'s tokenizer?
\b (kelime sınırı) sayesinde “OpenAI” içindeki “AI” ayrıca eşleşmez, “AI’s” gibi iyelik ekli biçimler ise doğru yakalanır.
Bunun yanında üç kural daha koyduk:
- Senaryoda “AI” kelimesini cümlenin ilk ya da son kelimesi yapmıyoruz. “AI is not magic.” yerine “Artificial intelligence is not magic.” gibi bir cümle hem daha doğal hem daha güvenli.
- Kısaltma geçen cümleleri render’dan önce ayrı klipler halinde kulakla dinliyoruz. Whisper kontrolü kelime yutmayı ve tekrar etmeyi yakalıyor, telaffuz hatasını yakalamıyor.
- Yanlış çıkan cümleyi yalnızca onun tohumunu değiştirerek yeniden üretiyoruz. Seslendirmenin geri kalanı önbellekte kalıyor.
Sorunu Geliştiricilere Bildirdik
Bu sonucun yalnızca bizim kurulumumuza özgü olmadığı belliydi. Chatterbox’ın GitHub deposunda aynı sorunu anlatan bir kayıt zaten vardı: #400 “Abbreviations pronounced wrong”. Aralık 2025’ten beri açıktı ve hiç yorum almamıştı. Yeni bir kayıt açmak yerine bu kayda test tablomuzu ve cümlelerimizi yorum olarak ekledik. Aynı metin ve tohumla bile telaffuzun değişebildiğini anlatan #550 numaralı kayıt da yakından ilgili.
Önerimiz basit: modelin İngilizce tarafına, büyük harfli kısaltmaları harflerine ayıran bir metin normalleştirme adımı eklenmesi. Bu yapılana kadar yukarıdaki sözlük yöntemi işimizi görüyor.
Testin Sınırları
- Bütün klipleri tek bir kişi dinledi ve bu kişinin ana dili İngilizce değil. Farklı kulaklar bazı “emin değilim” puanlarını farklı verebilir.
- Her cümle-yazım çifti için yalnızca 6 klip var. Konum etkisi belirgin ama kesin oranlar için az.
- Yalnızca Chatterbox Multilingual 0.1.7 sürümünü, varsayılan ayarlarla (exaggeration 0,5, cfg 0,5) test ettik. Yalnızca İngilizce için geliştirilen Chatterbox modelleri farklı davranabilir.
Ne Öğrendik?
- Kısaltma okuma hatası rastgele değil, sistematik: düz “AI” bu modelde hiçbir zaman doğru okunmadı.
- Bir seslendirme kontrolünün metni doğru bulması, sesin doğru olduğu anlamına gelmiyor. Telaffuzu ancak kulak yakalıyor.
- Kulak testini ölçülebilir hale getirmek zor değil: küçük bir dinleme sayfası ve klavye kısayollarıyla 162 klip kısa sürede puanlanabiliyor.
- Sorunun nerede olduğunu bulmak için karşılaştırma yapmak gerekiyor. İki sesi yan yana test etmeseydik, suçu yavaşlattığımız referans sese atacaktık.
Yerelde çalışan yapay zekâ araçlarıyla ilgileniyorsanız, Python, Flask ve Ollama ile yerel bir sohbet asistanı kurduğumuz yazıya da göz atabilirsiniz.
Kaynaklar
- Chatterbox — Resemble AI (GitHub)
- Chatterbox #400: Abbreviations pronounced wrong
- Chatterbox #550: IPA / phoneme input support + improved pronunciation consistency
- OpenAI Whisper
- Starfield Code — AI Explained Visually oynatma listesi
Ahmet Aksoy & Claude