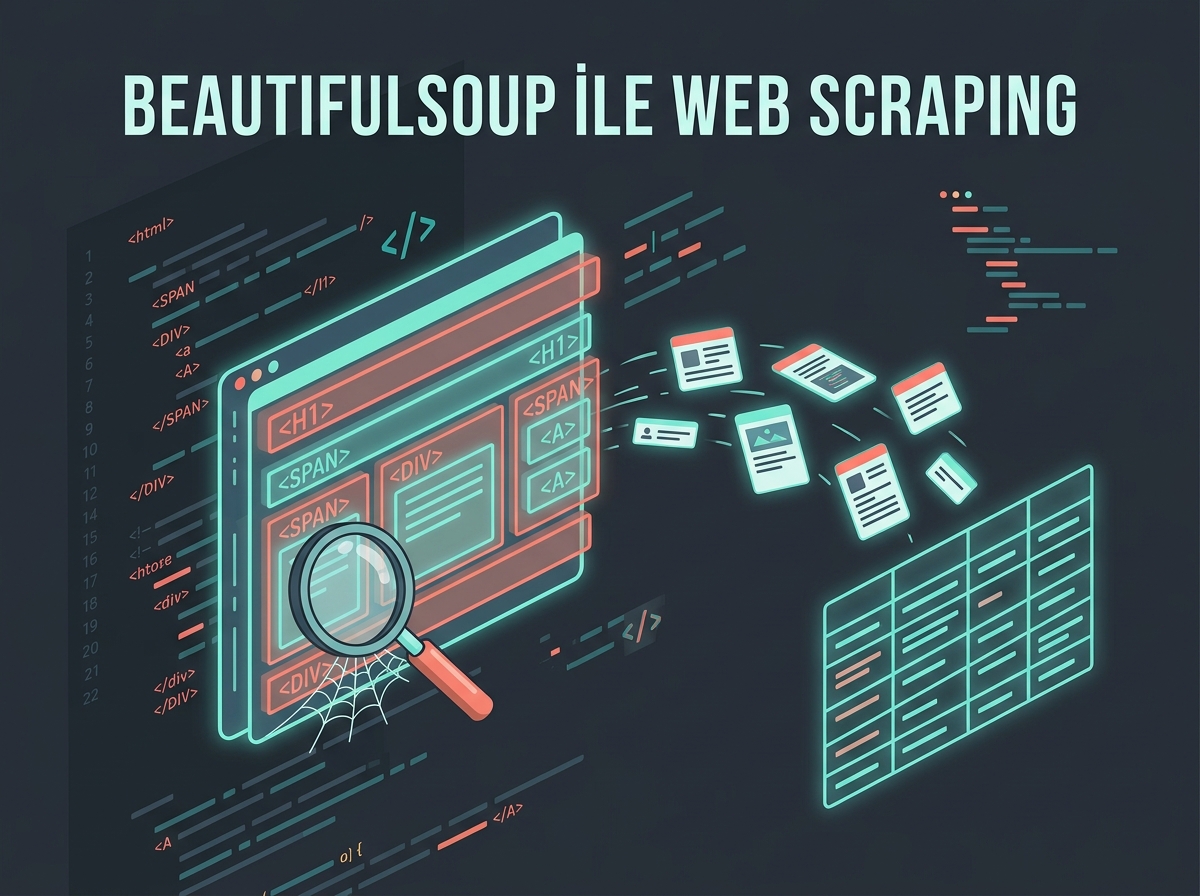

Bir web sayfasına baktığınızda gördüğünüz güzel tasarım, aslında tarayıcının arkasında iç içe geçmiş yüzlerce HTML etiketinden ibarettir. Peki o karmaşadan yalnızca ihtiyacınız olan başlığı, yazarı veya linki nasıl çekip alırsınız? İşte tam burada Python’ın en sevilen kütüphanelerinden biri olan BeautifulSoup devreye giriyor.
Bir Web Sayfasını Veri Madenine Çevirmek
Web scraping (web kazıma), bir internet sayfasının ham HTML kodunu indirip, içindeki yapısal verileri programatik olarak ayıklama işlemidir. Elle kopyala-yapıştır yapmak yerine, bu işi bir script’e devredersiniz; script sizin adınıza yüzlerce sayfayı saniyeler içinde tarayabilir.
Bu projede iki kütüphane bir araya geliyor:
- requests: Bir web sunucusuna HTTP isteği gönderip ham HTML yanıtını almamızı sağlıyor. Bu kütüphaneyi daha ayrıntılı biçimde Python requests Kütüphanesi ile HTTP Dünyasına Giriş yazımızda ele almıştık.
- BeautifulSoup4 (bs4): Gelen ham HTML metnini, üzerinde gezinebileceğimiz (DOM gezintisi/traversal) bir ağaç yapısına dönüştürüyor.
Örnek script, bir blog sayfasındaki <article class="blog-post"> bloklarını hedef alıyor ve her birinden başlık, yazar adı ve link bilgisini çekiyor. Eğer hedef sayfa bu düzene sahip değilse (ki örnek kod example.com üzerinde çalıştığı için bu durumla karşılaşıyor), script çökmek yerine sayfanın başlığını göstererek zarifçe geri çekiliyor (graceful fallback).
Bu teknik, gerçek dünyada oldukça geniş bir kullanım alanına sahip: e-ticaret sitelerinde fiyat takibi yapmak, haber sitelerinden başlıkları toplayıp bir özet panosu oluşturmak, akademik araştırmalar için kamuya açık verileri derlemek veya kendi sitenizin SEO durumunu (başlık etiketleri, meta açıklamalar) toplu olarak denetlemek gibi. Elbette her durumda hedef sitenin kullanım şartlarına ve robots.txt dosyasına uymak gerekiyor — bu konuya “Ne Öğrendik?” bölümünde tekrar döneceğiz.
Proje bilgisi: Yazar: Ahmet Aksoy · Tarih: 27.05.2026 · Ortam: Python 3.12, Ubuntu 24.04
Kodun Anatomisi
Kodun kalbinde üç aşamalı bir akış var: istek gönder → ayrıştır → hedefle.
İlk aşamada, sunucuya kendimizi tanıtan bir User-Agent başlığı (header) ile istek gönderiyoruz. Bunu yapmamızın nedeni basit: birçok sunucu, tarayıcı kimliği taşımayan istekleri şüpheli bulup engelleyebiliyor.
headers = {
    "User-Agent": "Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:120.0) Gecko/20100101 Firefox/120.0"
}
response = requests.get(url, headers=headers, timeout=10)

if response.status_code != 200:
    print(f"[Error] Failed to connect. HTTP Status Code: {response.status_code}")
    return
Dikkat edilmesi gereken bir başka nokta da timeout=10 parametresi. Ağ istekleri bazen hiç yanıt vermeyen bir sunucuya takılıp kalabilir; zaman aşımı (timeout) koymazsanız programınız sonsuza kadar bekleyebilir.
İstek başarılı olduğunda, ham metni BeautifulSoup’a teslim ediyoruz. html.parser argümanı, Python’ın kendi yerleşik (built-in) ayrıştırıcısını kullanmasını söylüyor — ekstra bir bağımlılık kurmaya gerek kalmıyor:
soup = BeautifulSoup(response.text, "html.parser")
articles = soup.find_all("article", class_="blog-post")

for idx, article in enumerate(articles, start=1):
    title_element = article.find("h2", class_="post-title")
    title_text = title_element.get_text(strip=True) if title_element else "No Title"

    link_element = article.find("a")
    link_href = link_element["href"] if link_element and link_element.has_attr("href") else "No Link"

    author_element = article.find("span", class_="post-author")
    author_name = author_element.get_text(strip=True) if author_element else "Anonymous"

    print(f"\n[Post #{idx}]")
    print(f" Title  : {title_text}")
    print(f" Author : {author_name}")
    print(f" Link   : {link_href}")
Burada find_all() ile sayfadaki tüm eşleşen blokları bir listeye topluyoruz, find() ile de her bloğun içinde tek bir alt öğeyi arıyoruz. get_text(strip=True) ise metnin başındaki/sonundaki boşlukları temizleyerek düz metni döndürüyor. has_attr("href") kontrolü de savunmacı programlama (defensive programming) örneği: bir <a> etiketinin her zaman href özniteliğine sahip olacağını varsaymak yerine önce kontrol ediyoruz.
Son olarak, ağ hataları try/except bloğuyla yakalanıyor. requests.exceptions.RequestException, bağlantı kopması, DNS hatası veya zaman aşımı gibi pek çok senaryoyu tek çatı altında topluyor, böylece program beklenmedik şekilde çökmüyor.
Hangi Ayrıştırıcıyı (Parser) Seçmeli?
Kodda BeautifulSoup(response.text, "html.parser") satırındaki ikinci argüman, aslında BeautifulSoup’a “HTML’i hangi motorla oku” dediğimiz yer. Python ekosisteminde üç yaygın seçenek var:
html.parser: Python’ın standart kütüphanesiyle birlikte gelir, ekstra kurulum gerektirmez. Bu proje için tercih edilen seçenek de bu — çünkü bağımlılıkları minimumda tutuyor.lxml: Çok daha hızlı çalışır ve bozuk HTML’e karşı daha toleranslıdır, ama ayrı bir paket (pip install lxml) olarak kurulması gerekir. Büyük ölçekli kazıma projelerinde tercih edilir.html5lib: Tarayıcıların HTML5 yorumlama mantığını birebir taklit eder, en yavaş ama en “doğru” sonucu veren seçenektir.
Küçük projeler ve öğrenme amaçlı denemeler için html.parser fazlasıyla yeterli; performans kritik hale geldiğinde lxml‘e geçmek mantıklı bir sonraki adım.
Alternatif Bir Yol: CSS Seçicileri
find() ve find_all() yerine, CSS’e aşinaysanız select() metodunu da kullanabilirsiniz. Aynı işi CSS seçici sözdizimiyle yapmak isterseniz kod şu şekle bürünür:
# find_all yerine CSS seçici kullanan eşdeğer satır
articles = soup.select("article.blog-post")
title_text = article.select_one("h2.post-title").get_text(strip=True)
İki yaklaşım da aynı sonucu üretir; hangisini kullanacağınız büyük ölçüde kişisel tercihe ve ekibinizin alışkanlıklarına bağlı.
Nasıl Çalıştırılır?
Öncelikle gerekli kütüphaneleri sanal ortamınıza (virtual environment) kurun:
pip install requests beautifulsoup4Ardından script’i çalıştırın:
python3 main.pyKod varsayılan olarak https://example.com adresini hedefliyor. Bu sayfa çok sade bir yapıya sahip olduğu için blog-post sınıflı bir öğe bulunamayacak ve script otomatik olarak sayfa başlığını yazdıracaktır:
=== Extracted Article Elements ===
[Warning] No elements matched the target class layout.
Displaying raw page title instead as fallback:
Page Title Tag -> Example Domain
Gerçek bir blog düzeninde nasıl çalıştığını görmek isterseniz, target_sandbox_url değişkenini kendi test ortamınızdaki (veya izniniz olan) bir sayfaya çevirip <article class="blog-post"> yapısına sahip HTML içeren bir sayfa üzerinde deneyebilirsiniz.
Ne Öğrendik?
Bu küçük ama öğretici projede şunları gördük:
- HTTP isteği göndermek:
requestsileUser-Agentvetimeoutparametrelerinin neden önemli olduğunu; bu iki ayrıntının eksikliği gerçek projelerde sık karşılaşılan “sunucu beni engelliyor” veya “programım donuyor” şikayetlerinin başlıca nedenidir. - DOM ayrıştırma: BeautifulSoup’un ham HTML’i, üzerinde
.find(),.find_all()veya.select()ile gezinebileceğimiz hiyerarşik bir ağaca (DOM ağacı) nasıl çevirdiğini. - Hedefli veri çekme: Belirli etiket ve sınıflara odaklanarak, sayfadaki gürültüden (reklamlar, menüler, footer) sıyrılıp yalnızca ihtiyacınız olan veriyi nasıl ayıklayacağınızı.
- Zarif hata yönetimi: Beklenmeyen sayfa yapıları veya ağ hataları karşısında programın çökmek yerine anlamlı bir geri bildirim vermesinin, özellikle uzun süre çalışan otomasyon script’lerinde neden kritik olduğunu.
- Ayrıştırıcı seçimi:
html.parser,lxmlvehtml5libarasındaki hız/doğruluk/bağımlılık dengesini.
Etik ve Sorumlu Kazıma
Web scraping öğrenirken akılda tutulması gereken en önemli kural şu: her sitenin robots.txt dosyasına (genellikle https://site.com/robots.txt adresinde bulunur) ve kullanım şartlarına saygı gösterin. İstekler arasına küçük bekleme süreleri (time.sleep()) ekleyerek sunucuyu aşırı yüklemeyin, mümkün olduğunda resmi bir API sunuluyorsa onu tercih edin ve topladığınız verileri yalnızca izin verilen amaçlar için kullanın. Bu disiplin, hem etik bir zorunluluk hem de IP adresinizin engellenmesini önleyen pratik bir tedbirdir.
Kaynaklar ve Sonraki Adımlar
Bu projeyi bir adım öteye taşımak isterseniz, gerçek bir siteyi (izniniz dahilinde) hedefleyen ve verileri bir CSV veya JSON dosyasına kaydeden bir sürüm yazmayı deneyebilirsiniz. Örneğin csv modülünü kullanarak her [Post #idx] bloğunu bir satıra dönüştürüp veriler.csv dosyasına yazmak, script’i tek seferlik bir gösterimden gerçek bir veri toplama aracına dönüştürür. Bir sonraki adım olarak, tek sayfa yerine “sonraki sayfa” (pagination) linklerini takip ederek birden fazla sayfayı sırayla gezen bir döngü eklemeyi de deneyebilirsiniz.
Daha kapsamlı, çoklu sayfa gezen ve hata toleransı daha yüksek bir kazıyıcı mimarisi için Python ile Kapsamlı Web Kazıyıcı (Web Scraper) Uygulaması Geliştirme yazımıza göz atabilirsiniz. HTTP istekleri, oturum (session) yönetimi ve kimlik doğrulama konularını daha derinlemesine öğrenmek isteyenler için de requests yazımız iyi bir devam noktası olacaktır.
Ahmet Aksoy
Not: Bu yazıda incelediğimiz kodu ve benzer projelerin kaynak kodlarını https://github.com/ahmetax/practical-python-examples adresinde bulabilirsiniz.